Nvidia представила Rubin HPC із понад 50 тисячами ядер CUDA
Nvidia представила прискорювач Rubin HPC із понад 50 тисячами ядер CUDA для наукових обчислень, який очікується у системах у 2028 році.
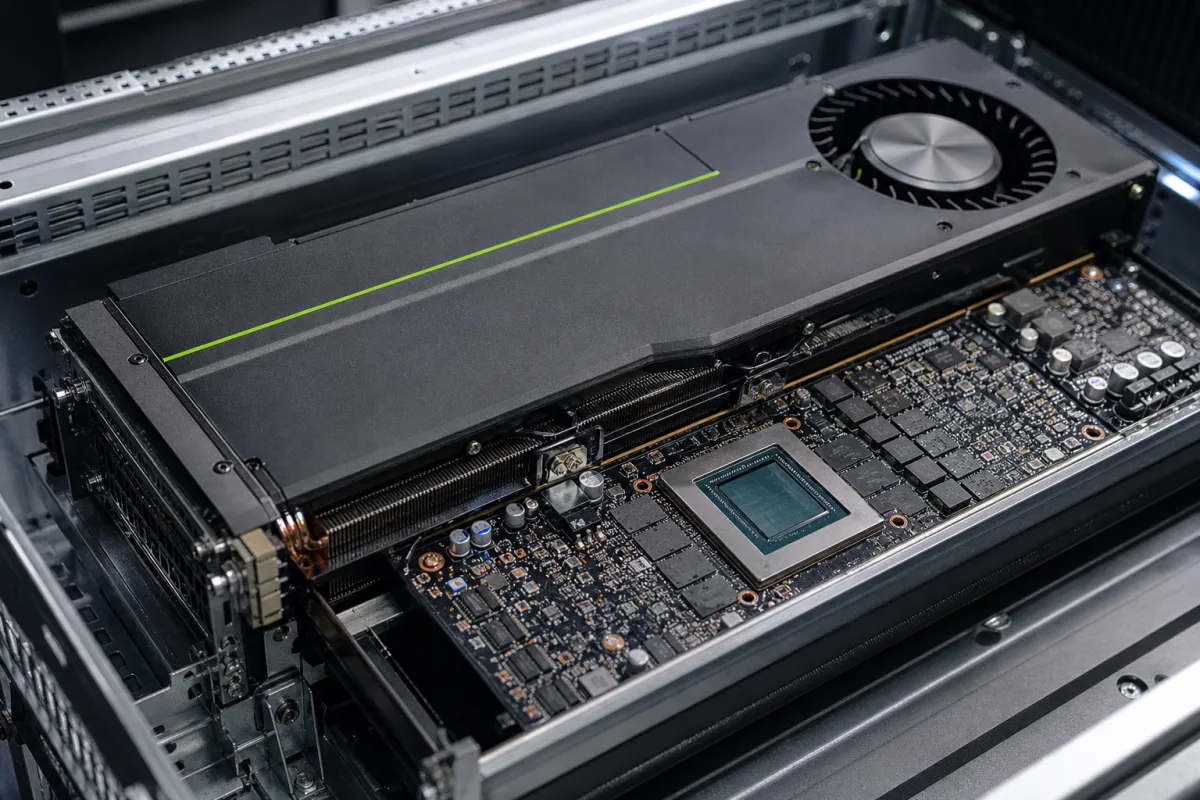
Nvidia представила прискорювач Rubin HPC для наукових обчислень, який містить понад 50 тисяч ядер CUDA в одному графічному процесорі. Компанія позиціонує новинку для складного моделювання й аналізу даних, а не для споживчих ігор або звичайної настільної графіки. Як повідомляє TechRadar, системи з Rubin HPC очікуються у 2028 році.
Прискорювач анонсували на конференції суперкомп'ютерів SC26. Він стане частиною платформи Nvidia Vera Rubin як спеціалізоване рішення для технічних навантажень. За заявою компанії, чип має допомогти дослідникам виконувати симуляції матеріалів і молекул, аналізувати промислові конструкції, кліматичні системи та інші складні наукові процеси.
Майже втричі більше ядер за RTX 5090
Кількість ядер CUDA у Rubin HPC майже втричі перевищує показник GeForce RTX 5090, яка має 21 760 таких ядер. Різниця становить понад 28 240 ядер. Водночас пряме порівняння цих продуктів обмежене їхнім різним призначенням: Rubin HPC розробляють для високопродуктивних обчислень, тоді як RTX 5090 належить до лінійки GeForce.
Конструкція Rubin HPC поєднує велику кількість обчислювальних ядер із прискореним передаванням даних між компонентами. Nvidia заявляє, що це має зменшувати простої обчислювальних блоків, які виникають під час очікування даних у ресурсоємних наукових розрахунках.
Підтримка роботи з розрідженими даними
Новий прискорювач також отримав механізми для роботи з розрідженими даними — операціями, за яких під час розрахунків із великих наборів отримують лише обмежену частину інформації. У технічному описі Nvidia згадуються розріджені матриці, трафаретні обчислення, сортування та операції редукції. Такі задачі використовують у програмному забезпеченні для моделювання, аналітики та інженерних розрахунків.
Rubin HPC оснащений технологією Nvidia NVLink сьомого покоління для взаємодії кількох графічних процесорів у великих обчислювальних системах. Nvidia також пов'язує розробку з використанням ШІ-агентів у наукових та інженерних дослідженнях і вказує на підтримку бібліотек CUDA-X. Незалежних вимірювань продуктивності прискорювача для конкретних задач наразі немає.