ШІ-кластери з понад 100 тисяч прискорювачів виходять за межі одного дата-центру
Великі ШІ-кластери розподіляють між дата-центрами через обмеження енергопостачання, охолодження та простору.
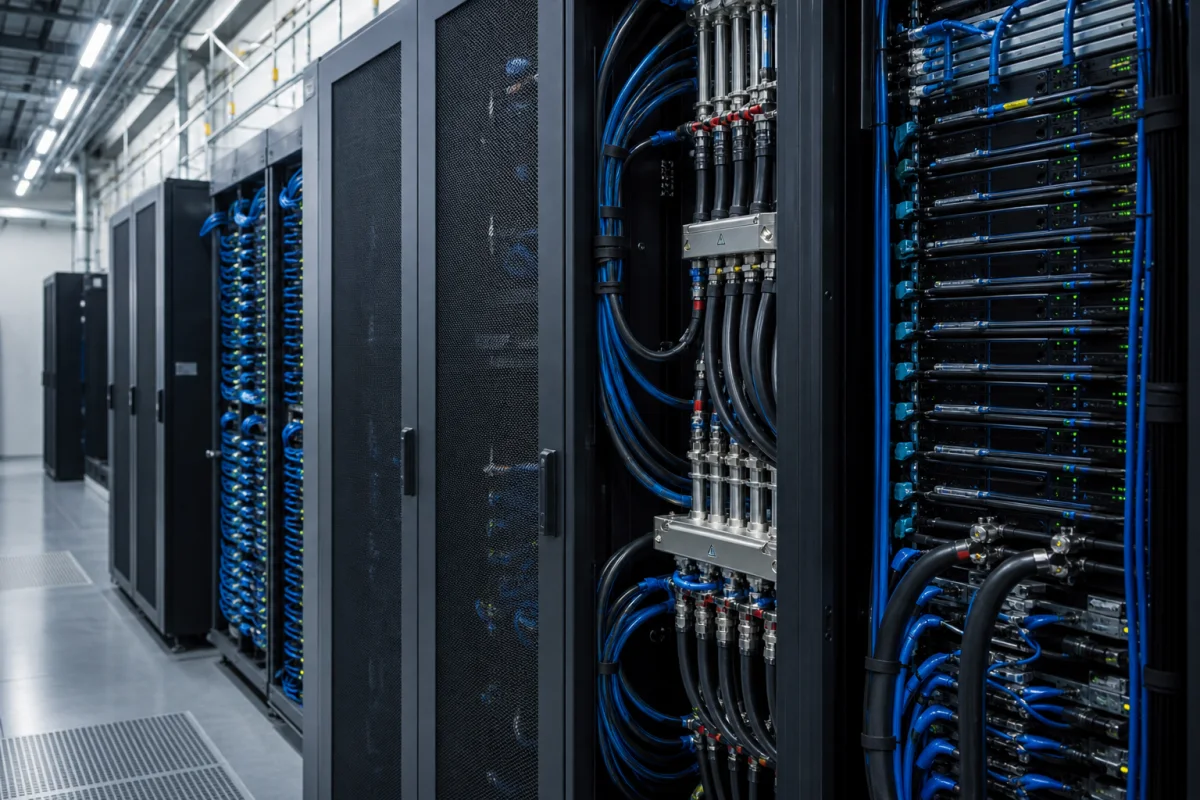
Зростання ШІ-кластерів, що можуть налічувати понад 100 тисяч прискорювачів і мільйони процесорних вузлів, змушує операторів розподіляти обчислення між кількома дата-центрами. Обмеження електропостачання, охолодження та фізичного простору ускладнюють розміщення такої інфраструктури в одному об’єкті, повідомляє Tom's Hardware.
Дослідники Університету штату Огайо представили на конференції Supercomputing 2026 підхід scale-across — високопродуктивне з’єднання обчислювальних ресурсів між різними будівлями, кампусами або регіонами. Його мета — об’єднувати ресурси кількох локацій замість концентрації надмірної кількості прискорювачів у межах одного дата-центру.
Новий рівень мережевої інфраструктури
Традиційно для високопродуктивних систем використовують два типи з’єднань. Scale-up поєднує процесори й прискорювачі у щільно інтегрованій системі; серед відповідних технологій названі AMD Infinity Fabric, Intel UPI, Nvidia NVLink та UALink. Scale-out з’єднує сервери або стійкові системи в більші кластери, зазвичай через Ethernet, InfiniBand, HPE Slingshot або Ultra Ethernet.
Розвиток продуктивності прискорювачів випереджає можливості комунікаційних систем. Тому швидші графічні процесори не гарантують пропорційного приросту продуктивності прикладних задач: ефективність дедалі більше залежить від пропускної здатності мережі, затримок і механізмів керування перевантаженнями.
Затримки та роль програмного забезпечення
З’єднання дата-центрів не перетворює два великі GPU-кластери на єдину тісно інтегровану систему. Навіть оптичні мережі не усувають затримок поширення сигналу на великих відстанях, а перевантаження, втрата пакетів і потреба в синхронізації можуть погіршувати фактичну продуктивність.
Це особливо важливо для навчання моделей ШІ, під час якого прискорювачі регулярно обмінюються параметрами моделей, градієнтами та проміжними результатами. Для таких навантажень мають значення топологія мережі, протоколи зв’язку, керування перевантаженнями й програмні реалізації колективних операцій.
Google раніше представила архітектуру мережі Virgo для ШІ-навантажень, що перевищують просторові та енергетичні можливості окремих дата-центрів. Cisco і Marvell також розробляють рішення для scale-across, зокрема маршрутизатори великої місткості, комутаційні чипи та оптичні з’єднання. Водночас мережеві адаптери можуть виконувати RDMA-операції без постійної участі центрального процесора, а технології на кшталт Nvidia SHARP і HPE Slingshot здатні переносити частину комунікаційних операцій у мережеву інфраструктуру.