У Hugging Face заявили про потребу стандартів оцінювання ШІ
У Hugging Face заявили, що для оцінювання ШІ-моделей та агентних систем потрібні спільні стандарти й відтворювані тести.
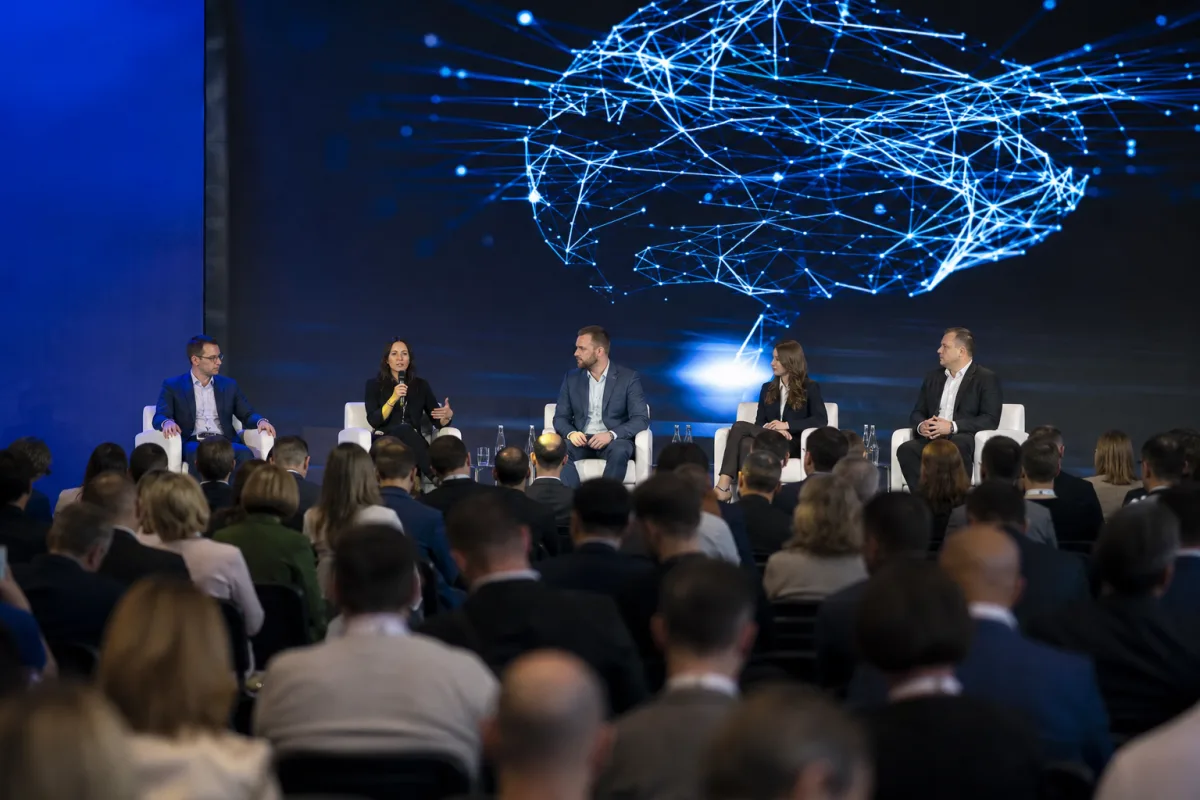
Директорка з питань політики Hugging Face Ірен Солейман заявила, що індустрії штучного інтелекту потрібні більш послідовні та стандартизовані підходи до оцінювання моделей. Під час TechCrunch Disrupt вона наголосила: наявні методи тестування складні, ще розвиваються і не завжди дають змогу змістовно зіставляти результати різних оцінок.
Про це TechCrunch повідомляє з посиланням на виступ Солейман. За її словами, важливим критерієм довіри до результатів є можливість відтворити оцінювання. Для цього необхідний достатній доступ до самої моделі, зокрема до її ваг.
Проблема зіставлення тестів
Солейман зазначила, що оцінювання моделей є сферою, яка еволюціонує, а індустрія поки не має способу коректно порівнювати різні тести між собою. За її оцінкою, такі методики можуть швидко втрачати ефективність, а екосистема оцінювань наразі недостатньо розвинена.
Вона також звернула увагу на інтерес до системи вбудованих оцінювачів — незалежних сторонніх спостерігачів, які працюють усередині організацій, що розробляють ШІ. Водночас критерії, за якими можна визначити компетентного оцінювача для різних завдань, потребують значно більшої стандартизації.
Оцінюють не лише модель
За словами представниці Hugging Face, оцінювання дедалі більше стосується не окремої моделі, а всієї системи довкола неї — зокрема інструменту доступу до моделі та агента. Такий інструмент може істотно впливати на результативність: слабша модель із кращим інструментом доступу здатна перевершити передову модель.
Солейман додала, що оцінювання агентних систем є складним і дорогим. Якщо тестів для самих моделей уже більше, то для інструментів доступу їх менше. Вона зазначила, що розробники створюють кращі методи оцінювання цілісних агентних систем, оскільки саме вони є джерелом практичної цінності для багатьох користувачів.