Дослідник ШІ Ендрю Нґ закликав зосередитися на якості даних
Ендрю Нґ пояснив, чому для практичних систем ШІ якість і розмітка даних можуть бути важливішими за їхній обсяг.
Дослідник штучного інтелекту та засновник Landing AI Ендрю Нґ вважає, що для багатьох практичних застосувань ШІ важливішим стає не нарощування масштабів моделей і наборів даних, а систематичне поліпшення самих даних. В інтерв’ю IEEE Spectrum він назвав цей підхід data-centric AI — дисципліною інженерної роботи з даними, потрібними для створення ефективної системи ШІ.
Нґ зазначив, що масштабування великих моделей і надалі матиме потенціал, зокрема для мовних моделей та майбутніх базових моделей комп’ютерного зору. Водночас обробка відео потребує значно більших обчислювальних ресурсів, ніж токенізований текст, тому створення таких моделей для відео ускладнене.
Від великих даних до якісних
За словами Нґ, упродовж попереднього десятиліття розробники переважно вдосконалювали код і архітектури нейромереж, працюючи з уже зібраними наборами даних. Тепер для багатьох завдань архітектури стали достатньо зрілими, тож продуктивніше фіксувати модель і поліпшувати дані для її навчання.
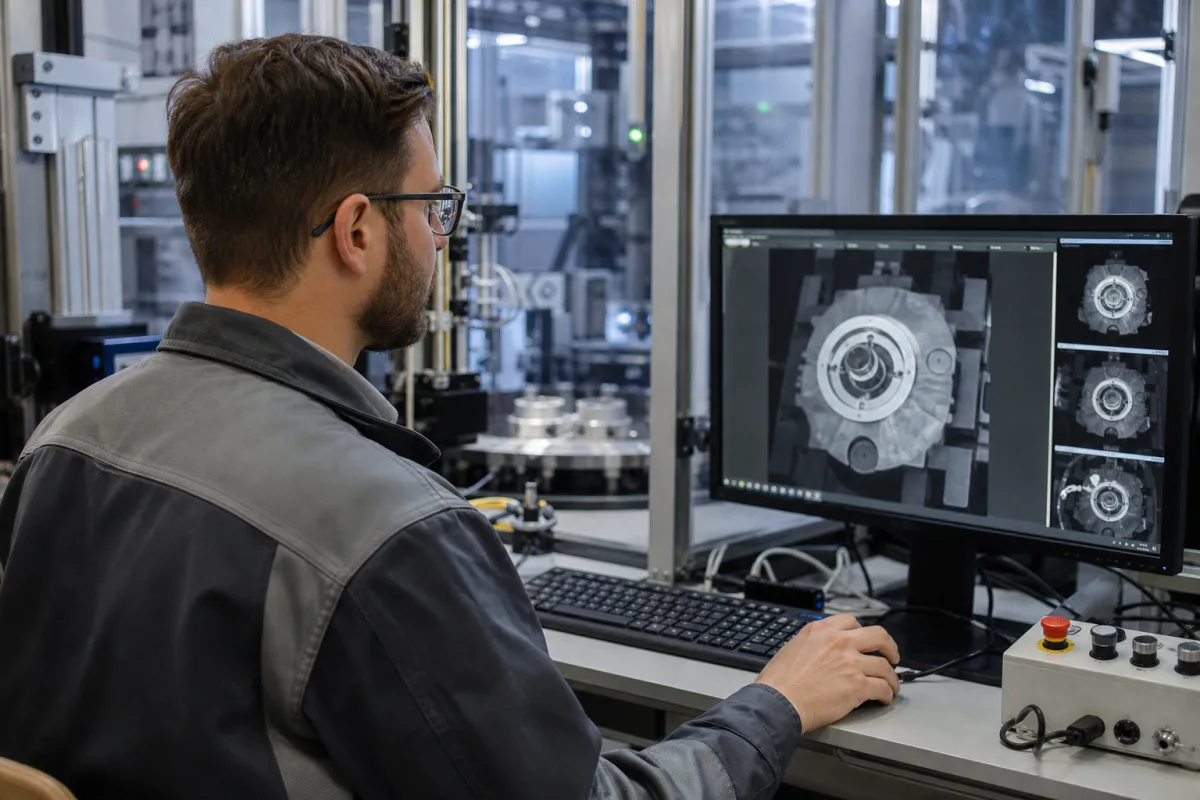
Він навів приклад промислового візуального контролю: у галузях, де немає гігантських наборів даних, 50 ретельно підібраних і підготовлених прикладів можуть бути достатніми для навчання системи виявляти дефекти. Нґ наголосив, що моделі, розраховані на сотні мільйонів зображень, не працюють так само ефективно з кількома десятками прикладів.
Розмітка та синтетичні дані
Landing AI для виробників використовує попередньо навчену версію моделі RetinaNet, але Нґ назвав попереднє навчання лише частиною роботи. Важливішими він вважає інструменти, що допомагають відібрати релевантні зображення для донавчання моделі та послідовно їх розмітити.
За його словами, навіть люди-розмітники можуть по-різному класифікувати однакові дані. Замість накопичувати додаткові дані для всіх категорій, компанія пропонує виявляти ділянки з непослідовною розміткою та виправляти їх адресно. Наприклад, якщо серед 10 тисяч зображень 30 належать до одного класу й мають суперечливі позначки, їх можна швидко перемаркувати.
Нґ також назвав синтетичні дані важливим інструментом. Їх можна застосувати, коли аналіз помилок показує, що модель гірше розпізнає певний тип дефекту, наприклад точкові заглиблення на корпусі смартфона. У такому разі можна створити додаткові дані саме для проблемної категорії, а не розширювати весь набір.
Моделі для окремих виробництв
Landing AI навчає клієнтів самостійно коригувати дані, перенавчати та оновлювати моделі, зокрема коли змінюються вироби чи умови освітлення на виробничій лінії. Нґ пояснив, що на відміну від споживчих інтернет-сервісів, де кілька моделей можуть обслуговувати мільярд користувачів, у виробництві тисячам компаній можуть знадобитися тисячі індивідуальних моделей.